漫游鲸二手书店
淘二手好书+回收闲置图书
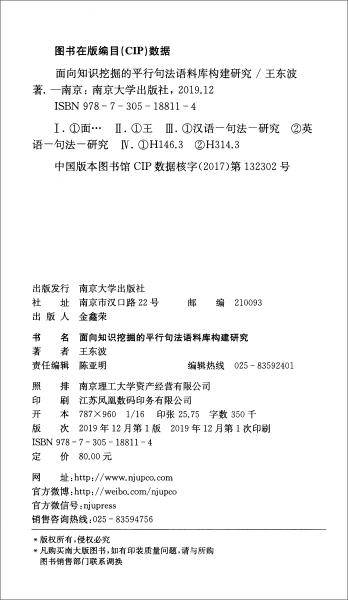
面向知识挖掘的平行句法语料库构建研究:数字人文视角下的史部典籍信息组织
王东波 | 南京大学出版社
ISBN:9787305188114
原价: ¥80.00
销售价:¥68.31元
参与书籍回收后,可享更低价格
分类
社会科学
作者
王东波
出版社
南京大学出版社
图书简介
《面向知识挖掘的平行句法语料库构建研究:数字人文视角下的史部典籍信息组织》基于自然语言处理中的句子对齐、自动分词、词性标注、实体识别和短语结构识别等技术,面向《左传》《战国策》《史记》《汉书》《后汉书》《三国志》的典籍文本和对应白话文本,构建了古白平行语料库,并结合传统机器学习和深度学习的系列模型,从数字人文的视角完成了对史部典籍的知识组织。在对史部典籍知识组织的基础上,对典籍中所蕴含的类别和涵盖的相应问题进行了知识的挖掘和探究。
阅读更多
相关推荐
-
面向知识挖掘的平行句法语料库构建研究:数字人文视角下的史部典籍信息组织
-
工商人类学视角下的组织文化研究
-
信息组织与信息构建
-
建模视角下的面向对象程序设计
-
数字人文视域下的古籍开发与应用模式研究
-
基于统计视角的数据挖掘研究
-
应用语料库语言学的多维视角
-
在线评论信息挖掘研究
更多低价好书购买/书籍回收

扫码访问微信小程序